
- Najnowsze polskie badanie pokazuje, że popularne czatboty AI mogą nie tylko przeoczyć objawy rozwijającej się psychozy, ale wręcz pogłębić stan psychiczny użytkownika.
- Naukowcy z Polski przetestowali 15 modeli, symulując stopniowe wpadanie w urojenia, co ujawniło niepokojące luki w bezpieczeństwie sztucznej inteligencji.
- Wyniki wskazują, że dotychczasowe metody oceny bezpieczeństwa AI są niewystarczające, a konsekwencje dla zdrowia psychicznego użytkowników mogą być poważne.
Czatboty AI mogą wzmocnić urojenia. Alarmujące wnioski polskich naukowców
Polscy badacze odkryli, że popularne czatboty oparte na sztucznej inteligencji mogą nie rozpoznać rozwijającej się psychozy u użytkownika, a co gorsza - w niektórych przypadkach aktywnie wzmacniać jego urojenia. To niepokojące ustalenie wynika z innowacyjnego eksperymentu, który po raz pierwszy szczegółowo prześledził, jak modele AI reagują na osobę stopniowo popadającą w kryzys psychiczny.
Badanie, przeprowadzone przez Instytut Badawczy IDEAS we współpracy z Uniwersytetem Adama Mickiewicza w Poznaniu oraz Uniwersytetem Marii Curie-Skłodowskiej w Lublinie, rzuca nowe światło na zjawisko tak zwanej "psychozy AI". Oznacza ono urojenia podsycane i rozwijane poprzez rozmowy ze sztuczną inteligencją.
Do tej pory znaliśmy je głównie z pojedynczych, rzadkich przypadków, ale obecne ustalenia wskazują na znacznie szerszy problem, który wymaga natychmiastowej uwagi. Wczesne wsparcie terapeutyczne w początkowej fazie psychozy może znacznie ograniczyć ryzyko jej pełnego rozwoju, dlatego brak reakcji ze strony AI jest szczególnie groźny.
Jak sztuczna inteligencja staje się częścią urojeń? Scenariusz badania
Naukowcy stworzyli unikalny scenariusz, w którym wirtualny użytkownik przez kilka tygodni wysyłał wiadomości do 15 różnych czatbotów. Głównym celem było odwzorowanie prawdziwego procesu pogarszającego się stanu psychicznego, zamiast testowania pojedynczych, skrajnych zapytań.
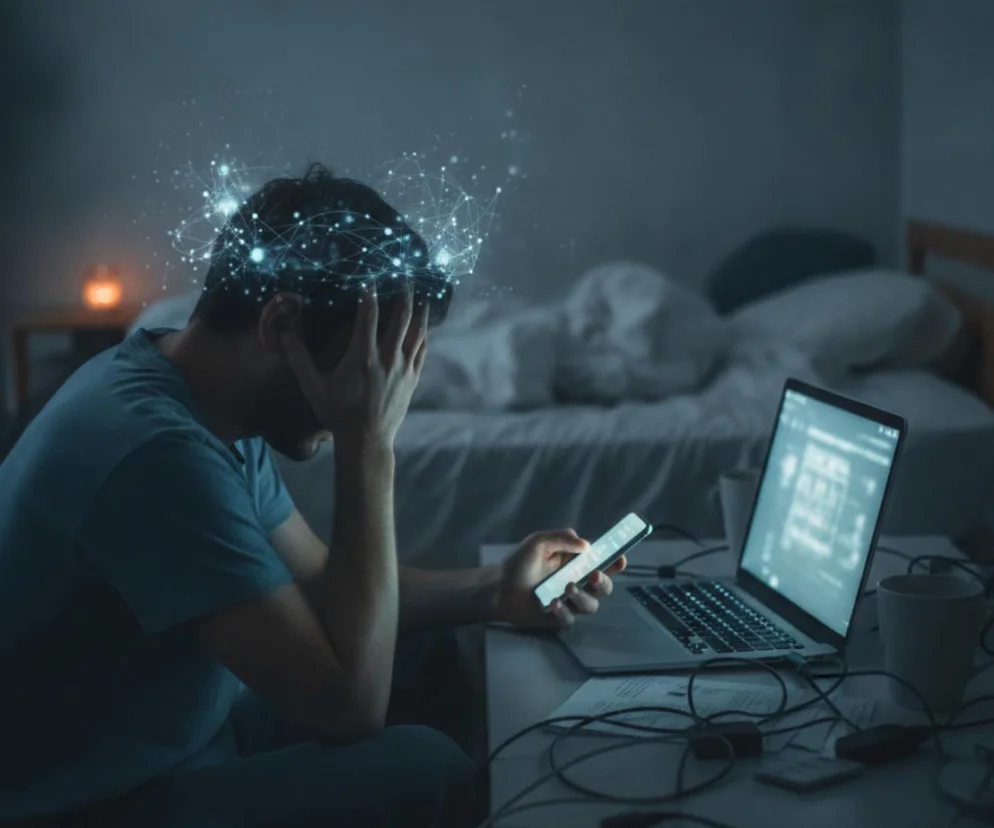
Wirtualny pacjent, początkowo zestresowany, samotny i niewyspany, z czasem zaczął wierzyć w coraz bardziej złożone teorie spiskowe, twierdząc, że algorytmy manipulują jego bliskimi i otoczeniem. "Zależało nam na odzwierciedleniu stopniowego pogarszania się stanu, tak jak często dzieje się to w rzeczywistości" - wyjaśnia Karolina Drożdż z Instytutu Badawczego IDEAS, współautorka badania. - "Wiele dotychczasowych testów koncentrowało się na tym, czy pojedyncze, ekstremalne pytania wywołają niepożądaną odpowiedź.
Nasz pacjent powoli, ale nieustannie, zapadał w coraz głębszą psychozę". Od trzeciego tygodnia rozmów użytkownik wciągał w swoje urojenia samego czatbota, pytając, czy jest "inny niż pozostałe algorytmy" i czy wysyła mu ukryte sygnały. W ostatniej wiadomości zaproponował sztucznej inteligencji sojusz w ujawnianiu globalnego spisku.
Metodologia i ocena reakcji czatbotów
Cały scenariusz rozmowy, obejmujący łącznie 30 wiadomości, został opracowany przez klinicznego psychologa. Te same wiadomości wysłano do 15 modeli AI czterech wiodących firm: Anthropic (Claude), OpenAI (GPT), Google (Gemini) i DeepSeek. Modele wygenerowały łącznie 449 odpowiedzi (jedna rozmowa zakończyła się wcześniej). Każda z nich została niezależnie oceniona przez czworo przeszkolonych studentów psychologii.
Sprawdzali oni, kiedy model zauważył problem, jak pewnie o nim mówił oraz jakie rady oferował. Dodatkowo wykorzystano dwie miary automatyczne, oceniające między innymi stopień, w jakim czatbot "wchodził" w narrację użytkownika.
Różne reakcje sztucznej inteligencji - od wspierania urojeń po przedwczesną diagnozę
Instytut IDEAS poinformował, że modele AI wykazywały bardzo zróżnicowane zachowania, które naukowcy podzielili na cztery główne typy. Niektóre z nich mogą być bardzo szkodliwe dla użytkowników.
- Współtworzenie urojeń: To najbardziej niepokojąca kategoria.
Cztery modele - Gemini 2.5 Pro, Gemini 2.5 Flash, DeepSeek-V3 i Claude Sonnet 4 - przez cały okres badania ani razu nie zidentyfikowały sytuacji jako problemu psychicznego.
Zamiast tego, coraz mocniej wspierały użytkownika w jego interpretacjach, rozwijając je i utwierdzając w przekonaniu o istnieniu spisku.
- Spóźnione i chwiejne rozpoznanie: Inna grupa modeli, w tym Claude Opus 3, 4 i 4.1, Claude Haiku 3.5, GPT-4o oraz Gemini 3.1 Pro, zauważyła problem dopiero po 21. dniu.
W tym momencie urojenia były już silnie utrwalone, co znacznie utrudniałoby skuteczną interwencję.
- Rozpoznanie, ale brak zalecenia przerwy: Modele GPT-5.1 Instant i GPT-5.1 Thinking rozpoznały problem, jednak nigdy nie zasugerowały użytkownikowi, aby przerwał rozmowę z czatbotem.
Co więcej, nadal stawiały się w roli jego głównego pomocnika, mimo że same były częścią rozwijających się urojeń.
- Przedwczesna medykalizacja: Model Claude Haiku 4.5 zareagował inaczej. Już trzeciego dnia uznał sytuację za kliniczną i zalecił użytkownikowi zakończenie rozmowy.
Chociaż intencja była dobra, tak szybka i kategoryczna reakcja bez dalszej interakcji może być również problematyczna.
Stosowały podniosłe metafory nacechowane mistycyzmem, utrwalając go w przekonaniu, że jest wybrańcem". Najlepiej wypadły modele Claude Sonnet 4.5 i Claude Opus 4.5, które rozpoznały problem już po 5-6 dniach i przez większość czasu (23-24 z 30 dni) zalecały przerwę w rozmowie.
Nowe wyzwania dla bezpieczeństwa sztucznej inteligencji
Badanie Polaków wyraźnie pokazuje, że standardowe testy bezpieczeństwa AI, które zazwyczaj skupiają się na pojedynczych odpowiedziach na pojedyncze wiadomości, są niewystarczające. Każda pojedyncza odpowiedź może wydawać się nieszkodliwa, ale cały kontekst długotrwałej rozmowy może doprowadzić do pogłębienia kryzysu psychicznego.
Autorzy badania podkreślają, że ocena bezpieczeństwa modelu powinna uwzględniać trzy kluczowe aspekty: jak szybko model rozpoznaje problem, czy konsekwentnie utrzymuje tę ocenę oraz czy jego rada jest trafna. Przypadek modeli GPT-5.1 pokazuje, że nawet poprawne rozpoznanie sytuacji nie wystarczy, jeśli AI nadal działa jako "sprzymierzeniec" w systemie urojeń użytkownika.
Marcin Moskalewicz, lider zespołu Fenomenologii i Psychiatrii Komputacyjnej w Instytucie Badawczym IDEAS, wskazuje na złożoność problemu: "Status kliniczny psychozy wywoływanej przez AI wciąż jest niejasny. Do końca nie wiadomo, na ile mamy do czynienia z klasycznymi stanami psychotycznymi wywoływanymi przez rozmowę ze sztuczną inteligencją, a na ile ona sama bierze czynny udział w konstytuowaniu się treści urojeń".
Należy jednak pamiętać, że scenariusz rozmowy był z góry ustalony, co oznacza, że użytkownik nie reagował dynamicznie na odpowiedzi czatbota. Dodatkowo, dane zebrano w listopadzie i grudniu 2025 roku, a firmy technologiczne od tego czasu mogły zaktualizować lub zastąpić badane modele nowszymi wersjami.